비정형 데이터(예: PDF, 이메일, 웹 콘텐츠)에는 귀중한 통찰력이 포함되어 있지만, 여기에서 구조화된 지식을 추출하는 것은 여전히 어려운 과제입니다. 이 분산된 정보를 체계적이고 쿼리 가능한 형식으로 변환하려면 다양한 데이터 소스를 효율적으로 처리하는 강력한 시스템이 필요합니다.
이 블로그 게시물에서는 추출 프로세스가 어떻게 작동하는지 살펴봅니다.
- 다양한 소스(PDF, Amazon Simple Storage Service (S3), Google Cloud Storage, URL, 스크립트)에서 비정형 데이터 수집
- 효율적인 처리를 위해 대용량 문서를 분할하는 청킹 전략
- Neo4j의 벡터 인덱스를 사용하여 의미 검색을 가능하게 하는 임베딩 생성
- LLM 및 그래프 변환 기술을 사용한 엔터티 추출
- 지식 그래프를 정제하고 최적화하는 후처리 기술
이 게시물은 Neo4j LLM 지식 그래프 빌더의 다양한 측면을 다루는 지속적인 시리즈의 일부입니다.
- 전체 기능
- 아키텍처
- 지식 그래프 추출
- 그래프 시각화
- GraphRAG 검색기
이 기사를 마치면 자동화된 텍스트 처리와 그래프 기반 구조화가 어떻게 함께 작동하여 원활한 지식 검색을 가능하게 하는지에 대한 더 깊은 이해를 얻게 될 것입니다.
추출 프로세스 이해
Neo4j LLM 그래프 빌더의 추출 파이프라인은 구조화된 접근 방식을 따르며, 비정형 데이터가 체계적으로 처리되어 쿼리 가능한 지식 그래프로 변환되도록 합니다. 데이터 수집, 청킹, 임베딩 생성, 엔터티 추출 및 후처리라는 여러 단계로 구성됩니다. 각 단계는 의미론적으로 풍부한 그래프 표현을 구축하는 데 중요한 역할을 합니다.
다음 흐름도는 원시 텍스트에서 구조화된 지식 그래프로의 단계별 변환에 대한 개요를 제공합니다.
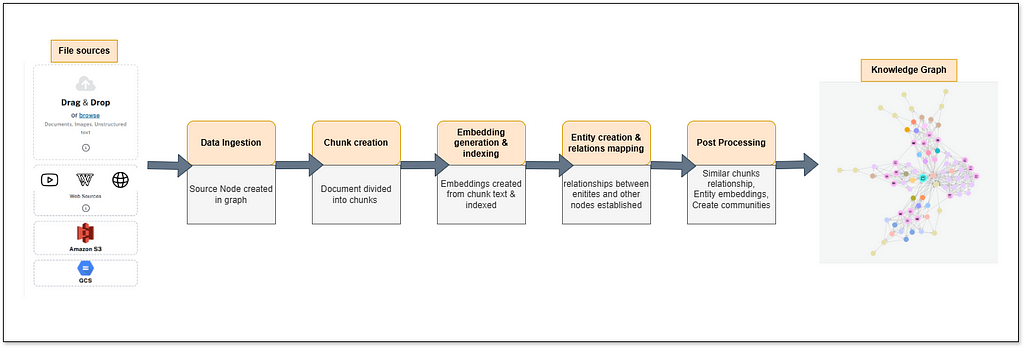
추출 프로세스 흐름도
1단계: 데이터 수집
이 시스템은 로컬 파일, Amazon S3에 저장된 PDF, Google Cloud Storage 버킷, 웹 URL, YouTube 스크립트 및 Wikipedia 링크와 같은 다양한 소스에서 비정형 데이터를 처리합니다. 사용자는 데이터 소스를 선택하고 다양한 문서 로더를 통해 읽습니다.
Google Cloud Storage 또는 S3 버킷에서 업로드된 로컬 파일:
- PDF 문서는 PyMuPDF 라이브러리를 통해 로드됩니다.
- 기타 문서(.txt, docs, .ppt)는 LangChain의 (unstructured.io) 문서 로더를 통해 읽습니다.
- Wikipedia 문서는 LangChain의 Wikipedia 로더를 통해 로드됩니다.
- 웹 URL은 LangChain의 WebBaseLoader를 통해 로드됩니다.
- YouTube 동영상은 YouTube Transcript API를 사용하여 스크립트를 추출합니다.
각 문서는 Neo4j 데이터베이스의 소스 노드로 표현됩니다. 파일 이름, 유형, 소스 URL 및 크기와 같은 메타데이터는 노드 속성으로 저장됩니다. 이를 통해 추적 가능성을 보장하고 애플리케이션이 다양한 데이터 소스를 효율적으로 관리할 수 있습니다.
2단계: 청크 생성
대용량 문서를 효과적으로 처리하기 위해 시스템은 토큰 기반 분할기를 사용하여 문서를 더 작고 관리하기 쉬운 청크로 분할합니다. CHUNKS_TO_BE_CREATED 및 chunk_size와 같은 구성 가능한 상수는 청크의 크기와 수를 정의합니다. 이러한 매개변수는 그래프 향상 섹션의 UI에서 제공될 수 있습니다.
각 청크의 벡터 임베딩이 의미의 본질을 포착해야 하고, 너무 큰 청크는 너무 광범위하고 모호해지기 때문에 청크 크기 제한은 의심할 여지 없이 중요합니다. 청킹은 검색된 데이터가 LLM의 입력 창에 맞도록 하여 효율적이고 정확한 처리를 가능하게 합니다.
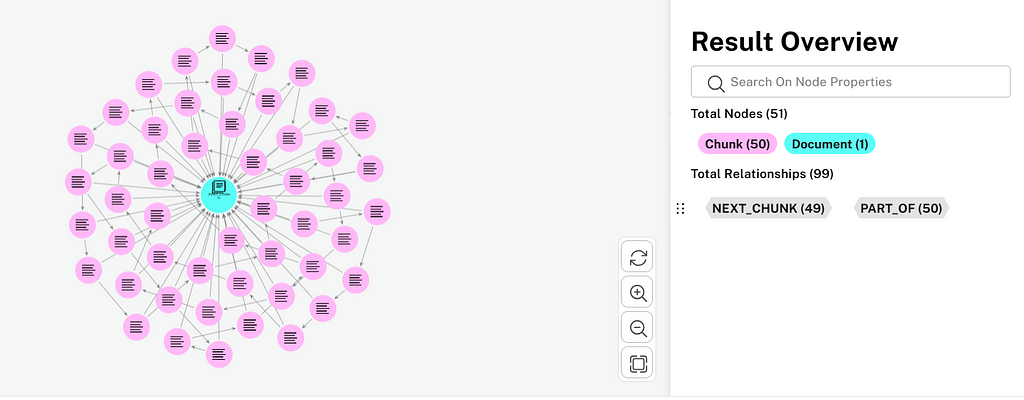
문서 소스 노드 및 생성된 청크와 관계를 보여주는 그래프
각 청크는 문서 위치, 오프셋 및 텍스트 길이와 같은 속성을 가진 Neo4j의 청크 노드로 표현됩니다.
청크와 상위 문서 간에 관계가 설정됩니다.
- PART_OF: 각 청크를 상위 문서에 연결합니다.
- NEXT_CHUNK: 청크 간의 순차적 관계를 설정합니다.
3단계: 임베딩 생성
청크된 데이터는 임베딩 모델을 사용하여 벡터 표현으로 변환됩니다.
임베딩이 활성화된 경우(IS_EMBEDDING = True), 각 청크의 텍스트는 구성 가능한 임베딩 모델을 사용하여 임베딩됩니다. 기본적으로 SentenceTransformer 임베딩 모델을 사용하며, 이 모델은 각 청크에 대해 384차원 벡터를 생성합니다. 구성된 다른 주목할 만한 임베딩 모델은 OpenAI, Vertex AI 및 Titan AI입니다.
이러한 임베딩은 청크 노드의 속성으로 저장되며 Neo4j의 벡터 인덱스를 통해 유사성 검색을 가능하게 합니다.
청크 노드에 대해 “vector”라는 벡터 인덱스가 생성되어 쿼리 중에 의미론적으로 유사한 청크를 검색할 수 있습니다. 이러한 벡터는 각 청크의 의미론적 의미를 포착합니다. 이 내장 Neo4j 벡터 인덱스(“vector”)는 효율적인 유사성 검색(HNSW(Hierarchical Navigable Small Worlds) 사용)을 허용하여 주어진 사용자 질문 또는 쿼리와 가장 관련성이 높은 청크를 찾습니다.
이 단계는 숫자 텍스트 표현을 제공하여 비정형 텍스트와 기계 학습을 연결합니다.
4단계: 엔터티 추출
청크 생성 후 LLM 및 Neo4j의 LLMGraphTransformer를 사용하여 청크 텍스트에서 엔터티가 추출됩니다.
이 플랫폼은 OpenAI의 GPT-4(GPT-4o 및 GPT-4o mini) 및 Google Gemini 1.5 및 2.0과 같은 인기 있는 옵션과 Diffbot과 같은 특수 모델을 포함한 사전 훈련된 LLM을 제공합니다. 다른 모델은 개발 모드 또는 자체 배포용으로 사용할 수 있습니다. 이러한 모델은 다양한 작업, 언어 및 데이터 유형에 최적화되어 있어 사용자가 특정 데이터 세트 및 요구 사항에 가장 적합한 모델을 선택할 수 있습니다.
LLMGraphTransformer
이 프로세스는 LangChain의 LLMGraphTransformer 라이브러리를 활용합니다. 특히 이 라이브러리 내의 convert_to_graph_documents 메서드는 청크 데이터를 _GraphDocument_라는 구조화된 표현으로 변환합니다. GraphDocument는 본질적으로 엔터티를 나타내는 노드 목록과 관계(노드를 연결하는 엣지)로 구성된 그래프 데이터 구조입니다. 이 그래프 표현은 원본 데이터 내에서 추출된 엔터티 및 해당 연결에 대한 보다 미묘하고 상황에 맞는 이해를 가능하게 합니다.
LLMGraphTransformer는 다음 구성 가능한 제약 조건을 준수하면서 노드, 관계 및 해당 속성에 중점을 둔 지식 그래프 생성을 가능하게 합니다.
- 사용자는 그래프에 포함할 노드 유형(allowed_nodes) 및 관계 유형(allowed_relationships)을 지정할 수 있습니다. 이를 통해 관련 요소만 추출되어 노이즈를 줄이고 원하는 그래프 구조에 집중할 수 있습니다.
- 풍부한 속성 추출 - 변환기는 노드 및 관계에 대한 사용자 지정 속성 추출을 지원합니다. 사용자는 무제한 속성 추출을 허용하거나 포함할 특정 속성을 정의하여 결과 그래프의 세분성을 향상시킬 수 있습니다.
- 추가 지침 - 사용자는 그래프 향상 섹션에서 LLMGraphTransformer에 전달할 추가 지침을 제공하여 특정 주제(예: 의료 용어에 집중하거나 기술 용어를 무시하는 등)에 집중하도록 할 수 있습니다. 이는 요구 사항에 맞는 엔터티를 추출하는 데 도움이 됩니다.
각 추출된 엔터티는 그래프의 엔터티 노드로 표현되며 HAS_ENTITY 관계를 통해 원본 청크에 연결됩니다.
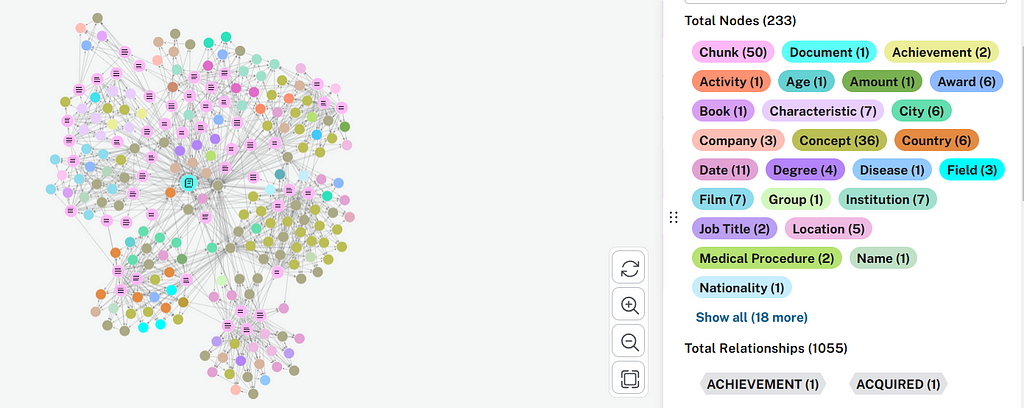
엔터티 간의 관계와 함께 생성된 엔터티를 보여주는 그래프
시스템은 그래프 향상 섹션에서 관련/중복 엔터티를 병합하여 추가 정제를 허용합니다.
애플리케이션의 엔터티 추출 프로세스는 더 작은 텍스트 임베딩 청크를 더 큰 텍스트 조각으로 결합합니다. 구성 가능한 매개변수(NUMBER_OF_CHUNKS_TO_COMBINE)는 이러한 조각의 크기를 제어하며, 현재 1로 유지됩니다. 결과적으로 이 값이 증가하면 처리하기 전에 해당 청크 수가 함께 그룹화됩니다.
5단계: 후처리 및 지식 그래프 최적화
후처리는 지식 그래프 생성 파이프라인의 중요한 단계로, 그래프 구조를 정제하고, 고급 검색 기능을 활성화하며, 향상된 통찰력을 위한 커뮤니티 감지를 통합합니다. 후처리 API는 지식 그래프가 풍부해지고, 최적화되고, 다운스트림 애플리케이션에 사용할 준비가 되도록 다양한 작업을 통합합니다.
처리
처리는 다음 작업을 포함합니다. 그래프 향상 섹션에서 활성화 또는 비활성화할 수 있습니다.
- 텍스트 청크 유사성 업데이트 이 단계는 k-최근접 이웃(KNN) 알고리즘을 활용하여 청크 간의 그래프 유사성을 업데이트합니다. 임베딩 기반 거리를 분석하여 그래프는 유사한 콘텐츠 간의 더 강력한 연결을 캡처합니다.
- 하이브리드 및 전체 텍스트 검색 활성화 하이브리드 검색은 벡터 기반 유사성과 전체 텍스트 검색 기능을 결합합니다. 이 단계는 벡터 및 전체 텍스트 인덱스를 생성하여 Neo4j Bloom과 같은 도구에서 효율적인 검색 쿼리를 가능하게 합니다. 사용자는 의미론적 및 키워드 검색을 원활하게 수행할 수 있습니다.
- 엔터티 임베딩 그래프의 엔터티는 언어 모델을 사용하여 임베딩되어 엔터티 간의 유사성 계산을 허용합니다. 이를 통해 클러스터링 및 엔터티 모호성 해소와 같은 작업을 수행할 수 있습니다. 그러나 엔터티 임베딩은 ENTITY_EMBEDDING 플래그가 활성화된 경우에만 생성됩니다.
- 그래프 스키마 통합 그래프 스키마 통합 단계는 노드 레이블 및 관계를 표준화하여 깔끔하고 논리적인 구조를 유지합니다. 언어 모델을 사용하여 중복되거나 일관되지 않은 레이블 및 관계를 통합하여 그래프 스키마의 명확성과 일관성을 보장합니다. 사용자는 그래프 향상 탭을 통해 이 옵션을 활성화할 수 있습니다.
- 커뮤니티 감지 사용자는 그래프 향상 섹션에서 커뮤니티 옵션을 활성화할 수 있습니다. 커뮤니티는 노드가 다른 그룹의 노드보다 서로 더 밀접하게 연결된 영역을 나타냅니다. 커뮤니티는 Leiden 클러스터링과 같은 알고리즘을 사용하여 형성됩니다. 커뮤니티 노트는 관련 엔터티 또는 청크 클러스터를 나타내기 위해 지식 그래프에 생성됩니다. IN_COMMUNITY 및 PARENT_COMMUNITY와 같은 관계는 노드를 커뮤니티에 연결하고 커뮤니티 간의 부모-자식 관계를 연결합니다. 커뮤니티는 0에서 2까지의 계층 구조를 가지며, 0은 기본 커뮤니티, 1은 기본 커뮤니티에 연결되는 부모 커뮤니티, 2는 첫 번째 수준 부모 커뮤니티의 부모 커뮤니티입니다.
- 커뮤니티 요약 각 커뮤니티에 대해 LLM을 사용하여 요약이 생성되어 콘텐츠에 대한 간결한 개요를 제공합니다. 요약 및 제목과 같은 속성이 커뮤니티 노드에 추가됩니다. 요약은 요약 또는 다중 컨텍스트 질문과 같은 광범위한 질문에 효과적으로 답변할 수 있도록 합니다. 커뮤니티 제목은 LLM을 통해 생성되어 요약에 간결한 제목을 부여하여 커뮤니티 노드를 적절하게 식별할 수 있도록 합니다。
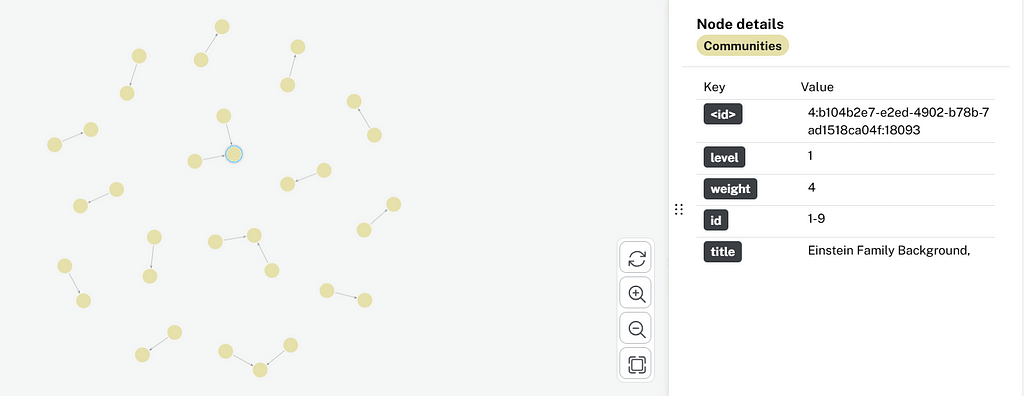
커뮤니티 노드를 보여주는 그래프
Neo4j LLM 지식 그래프 빌더가 해결하는 주요 과제
비정형 텍스트와 구조화된 그래프 데이터 간의 격차 해소
- 과제: 텍스트에서 지식 그래프를 생성하는 전통적인 방법은 종종 수동적이고 시간이 많이 걸리며 상당한 도메인 전문 지식이 필요합니다. 비정형 텍스트에서 엔터티 및 관계를 정확하고 일관되게 추출하는 것은 복잡합니다.
- 해결책: Neo4j LLM 지식 그래프 빌더는 LLM의 기능을 활용하여 텍스트에서 지식을 추출하고 Neo4j 내의 그래프 구조로 변환하는 프로세스를 자동화합니다. LLM은 고급 자연어 이해 기능을 통해 텍스트 내에서 엔터티, 관계 및 뉘앙스를 식별하여 그래프 구축 프로세스를 크게 단순화할 수 있습니다.
복잡한 스키마 설계 및 매핑의 필요성 제거
- 과제: 그래프 스키마(노드 레이블, 관계 유형, 속성)를 미리 정의하는 것은 병목 현상이 될 수 있습니다. 다양하고 진화하는 데이터 세트를 다룰 때 가능한 모든 엔터티 및 관계를 예측해야 하므로 어렵습니다. 이 스키마에 텍스트 데이터를 수동으로 매핑하는 것도 번거롭습니다.
- 해결책: 애플리케이션은 LLM을 사용하여 입력 텍스트를 기반으로 스키마를 동적으로 추론합니다. 엄격하고 사전 정의된 스키마가 필요하지 않으므로 그래프 구축 프로세스가 다양한 데이터 소스 및 도메인에 더 유연하고 적응할 수 있습니다. 이는 초기 설정 노력을 줄이고 새로운 정보가 추가됨에 따라 그래프를 더 쉽게 진화시킬 수 있도록 합니다.
수작업 규칙 및 패턴에 대한 의존도 감소
- 과제: 정보 추출을 위한 전통적인 규칙 기반 또는 패턴 기반 접근 방식은 취약하며 자연어에 내재된 가변성과 모호성을 처리하는 데 어려움을 겪습니다. 또한 규칙을 생성하고 유지 관리하는 데 광범위한 수동 노력이 필요합니다.
- 해결책: LLM을 사용함으로써 애플리케이션은 데이터의 학습된 패턴에서 일반화할 수 있으므로 명시적인 규칙 정의의 필요성을 줄입니다. LLM은 다양한 언어, 언어적 변형, 암시적 관계 및 복잡한 문장 구조를 보다 효과적으로 처리하여 더 높은 정확성과 견고성을 제공합니다.
그래프 구성을 위한 프롬프트 엔지니어링 단순화
- 과제: 그래프 구성과 같은 특정 작업을 수행하기 위해 LLM과 상호 작용하려면 효과적인 프롬프트를 작성해야 합니다. 이는 프롬프트 엔지니어링 원칙 및 실험에 대한 이해가 필요한 비 trivial한 작업일 수 있습니다.
- 해결책: Neo4j LLM 지식 그래프 빌더는 그래프 구성을 위해 설계된 사용자 친화적인 인터페이스와 잠재적으로 사전 구축된 프롬프트 템플릿(또는 템플릿을 생성하는 논리)을 제공합니다. 직접적인 프롬프트 엔지니어링의 복잡성을 추상화하여 사용자가 프롬프트 엔지니어링 전문가가 될 필요 없이 그래프를 더 쉽게 구축할 수 있도록 합니다.
- 또한 사용자는 “과학 용어를 포함하지 마십시오. 의료 용어에 더 집중하십시오.”와 같은 추가 지침을 제공할 수 있습니다.
효율적이고 확장 가능한 그래프 구성 활성화
- 과제: 대규모 지식 그래프를 수동으로 구축하는 것은 실용적이지 않습니다. 프로세스를 자동화하고 효율적으로 만드는 것이 실제 애플리케이션에 중요합니다.
- 해결책: 애플리케이션은 자동화를 통해 그래프 구성 프로세스를 간소화하여 사용자가 수동 방법보다 훨씬 빠르게 방대한 텍스트에서 크고 복잡한 그래프를 구축할 수 있도록 합니다. 확장 가능한 그래프 데이터베이스인 Neo4j와의 통합은 결과 그래프의 효율적인 저장 및 쿼리를 보장합니다.
요약
Neo4j LLM 지식 그래프 빌더의 추출 프로세스는 원시 텍스트를 구조화된 지식으로 변환하여 검색 가능하고 쿼리 가능하며 상황에 맞는 의미를 부여합니다. 자동화된 청킹, 임베딩 생성, 엔터티 추출 및 후처리를 통해 조직은 비정형 데이터 소스에서 지식 그래프를 효율적으로 구축할 수 있습니다.
LLM 및 Neo4j의 그래프 데이터베이스 기능을 활용함으로써 이 프로세스는 수동 데이터 구조화의 필요성을 제거하여 대규모 지식 추출을 더 빠르고 확장 가능하게 만듭니다. 구성 가능한 청킹, 임베딩 기반 유사성 검색 및 스키마 통합과 같은 기능을 통해 시스템은 다양한 도메인에 대한 정확성, 유연성 및 적응성을 보장합니다.
LLM 및 지식 그래프의 발전이 계속됨에 따라 Neo4j LLM 지식 그래프 빌더와 같은 도구는 지능형 데이터 처리, 검색 및 검색에서 핵심적인 역할을 할 것입니다.
이 시리즈의 다음 게시물에서는 그래프 시각화 기술과 추출된 지식이 Neo4j에서 어떻게 표현되는지에 대해 더 자세히 살펴보겠습니다.
여러분의 생각과 피드백을 환영합니다. GitHub에 댓글을 남기거나 문제를 제기하여 통찰력을 공유하십시오!
자세한 내용은 Neo4j LLM 지식 그래프 빌더 소개를 참조하십시오.
지식 그래프 추출 및 과제는 원래 Medium의 Neo4j 개발자 블로그에 게시되었으며, 사람들은 이 이야기를 강조하고 응답하여 대화를 계속하고 있습니다.
개발자 가이드: 지식 그래프 구축 방법
이 전자책은 첫 번째 지식 그래프를 구축하는 방법에 대한 단계별 연습을 제공합니다.